



Télécharger les fichiers
- html_to_pdf.py : le script complet présenté ci-dessous
- requirements.txt : son unique dépendance, requests
- invoice.html : la facture d'exemple du guide sur les factures PDF, à convertir en premier
Installer et définir votre clé
Le script nécessite Python 3.9 ou une version plus récente et le paquet requests. Créez une clé API dans le portail et conservez-la dans la variable d'environnement IRONFANG_API_KEY plutôt que dans le fichier.
python -m venv .venv
. .venv/bin/activate
pip install -r requirements.txt
export IRONFANG_API_KEY="if_live_..."
Le script
"""Convert an HTML file to PDF with the Ironfang Render API.

Usage:
    export IRONFANG_API_KEY="if_live_..."
    python html_to_pdf.py invoice.html invoice.pdf

The HTML is sent to the hosted API and the PDF comes back in the response.
Needs Python 3.9 or newer and the requests package.
"""

import os
import sys
from pathlib import Path

import requests

API_URL = "https://api.ironfang.uk/render/v1/pdf"

FOOTER = (
    '<div style="font-size:9px;width:100%;text-align:center;'
    'color:#666;font-family:sans-serif">'
    'Page <span class="pageNumber"></span> of <span class="totalPages"></span>'
    "</div>"
)


def main() -> None:
    if len(sys.argv) != 3:
        sys.exit("Usage: python html_to_pdf.py INPUT.html OUTPUT.pdf")
    source, target = Path(sys.argv[1]), Path(sys.argv[2])

    key = os.environ.get("IRONFANG_API_KEY")
    if not key:
        sys.exit("Set IRONFANG_API_KEY to your Ironfang API key.")

    body = {
        "html": source.read_text(encoding="utf-8"),
        "paper_format": "a4",
        "print_background": True,
        # Inches, per side. The bottom margin leaves room for the footer.
        "margin": {"top": 0.6, "right": 0.5, "bottom": 0.8, "left": 0.5},
        # A footer on its own makes Chromium print its default date and
        # title header, so an empty header goes with it.
        "header_html": "<span></span>",
        "footer_html": FOOTER,
    }

    try:
        resp = requests.post(
            API_URL,
            headers={"Authorization": f"Bearer {key}"},
            json=body,
            timeout=60,
        )
    except requests.RequestException as exc:
        sys.exit(f"The request did not complete: {exc.__class__.__name__}")

    content_type = resp.headers.get("Content-Type", "")
    if resp.status_code != 200 or not content_type.startswith("application/pdf"):
        # Errors are JSON even though success is binary. Never save them
        # as the PDF.
        try:
            err = resp.json()["error"]
            detail = f"{err['code']}: {err['message']}"
        except (ValueError, KeyError, TypeError):
            detail = f"unexpected response ({content_type or 'no content type'})"
        retry = resp.headers.get("Retry-After")
        hint = f" Retry after {retry} seconds." if retry else ""
        sys.exit(f"HTTP {resp.status_code} {detail}.{hint}")

    target.write_bytes(resp.content)
    credits = resp.headers.get("X-Renderwolf-Credits", "?")
    print(f"Wrote {target}: {len(resp.content):,} bytes, {credits} credits used.")


if __name__ == "__main__":
    main()
L'exécuter
python html_to_pdf.py invoice.html invoice.pdfEn cas de succès, il affiche la taille et les crédits consommés, et invoice.pdf est une facture A4 d'une page avec un numéro de page dans le pied de page :
Wrote invoice.pdf: 69,936 bytes, 2 credits used.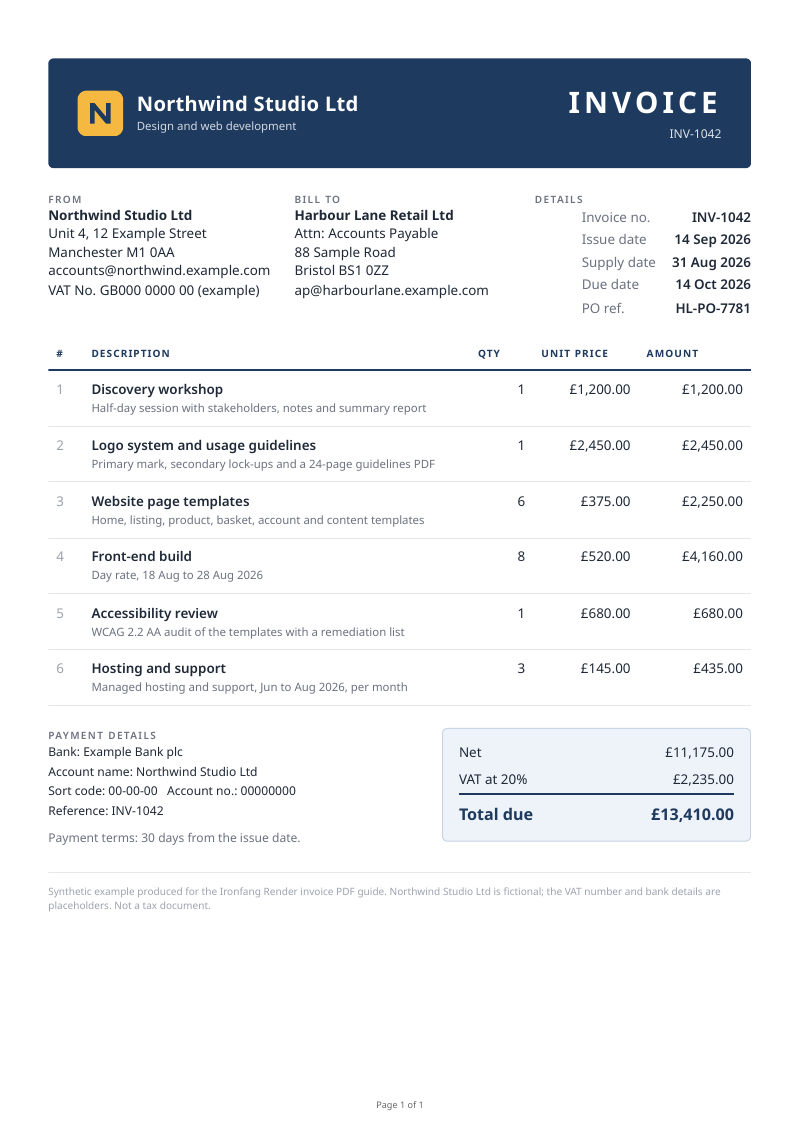
Ce que font les paramètres
- paper_format : a3, a4, a5, letter, legal ou tabloid. Sans ce champ, la page est au format Letter.
- print_background: true conserve les couleurs et images d'arrière-plan, que l'impression omet par défaut.
- margin : en pouces, pour chaque côté. Le pied de page est dessiné à l'intérieur de la marge inférieure, c'est pourquoi celle-ci est plus grande.
- header_html et footer_html : des modèles dessinés sur chaque page. Chromium remplit les classes pageNumber et totalPages. Envoyer un pied de page active les deux, c'est pourquoi un en-tête vide l'accompagne ; sinon, une date et le titre de la page apparaissent en haut.
En cas d'échec
Un succès est un code 200 avec Content-Type application/pdf, et c'est seulement dans ce cas que le fichier est écrit. Tout le reste est du JSON de la forme {"error": {"code", "message"}} ; le script l'affiche et se termine avec le statut 1. Quelques-unes des erreurs que vous pouvez rencontrer :
HTTP 401 invalid_api_key: missing or unknown API key.
HTTP 400 bad_request: paper_format must be one of a3, a4, a5, legal, letter, tabloid, got "a6".- 429 rate_limited : trop de rendus par minute pour le compte. Attendez, puis renvoyez la requête ; le script affiche Retry-After lorsque la réponse en contient un.
- 429 quota_exhausted : les crédits du mois sont épuisés. Le rendu est suspendu au lieu de facturer un dépassement.
- 422 render_failed : la page n'a pas pu être imprimée, par exemple parce qu'elle ne s'est pas chargée à temps. Les crédits correspondants sont remboursés.
Le script ne réessaie pas de lui-même. Si vous ajoutez de nouvelles tentatives, ne réessayez que les réponses 429 et 5xx, attendez entre les tentatives, et laissez de côté les 400 et 401 : elles échoueront de la même façon à chaque fois. Les messages d'erreur n'incluent jamais la clé ni le document.
Convertir du HTML depuis votre application
Le script lit un fichier, mais body["html"] peut être n'importe quelle chaîne construite par votre code, comme un modèle Jinja rendu. Échappez chaque valeur que vous insérez dans le HTML, comme le montre le guide sur les factures avec html.escape.
Quand une bibliothèque locale convient mieux
Des bibliothèques Python comme WeasyPrint convertissent le HTML en PDF sur votre propre machine avec leur propre moteur de mise en page, et Playwright pilote un Chromium local. Elles évitent un appel réseau et gardent les documents sur votre infrastructure, au prix de l'installation et de la mise à jour du moteur, de ses polices et de ses dépendances système, ainsi que de la mémoire et du temps qu'exige un navigateur. Une API hébergée convient à un service qui ne doit pas faire tourner lui-même un navigateur ; un moteur local convient au travail hors ligne ou aux documents qui ne doivent jamais quitter votre réseau.
Pour aller plus loin
- API HTML en PDF : fonctionnalités, limites et tarifs
- Convertisseur HTML en PDF gratuit : essayez d'abord un document dans le navigateur, sans clé
- Référence de la requête PDF : chaque champ, son type et ses limites
- Modèle de facture HTML avec un exemple PDF fonctionnel
- Captures d'écran de sites web en Python
- Référence complète de l'API